定位:让模型自己挑训练数据
官方把 Seed-Coder 的核心主张写成一句话:让代码模型自己为筛选数据。具体做法是主要依靠大模型而不是人工编写的规则来完成代码数据过滤,从而把预训练数据构造中的人力投入降到最低。官方把这一点列为第一条亮点,命名为「以模型为中心」。第二条亮点是透明——公开分享数据流水线的细节,包括 GitHub 数据、提交记录数据与代码相关网页数据各自的处理方法。第三条才是性能:官方称它在同等规模的开源模型中于多种编码任务上表现领先。
开源代码模型
Seed-CoderSeed-Coder 是字节 Seed 团队开源的 8B 代码模型家族,包含基础版、指令版与推理版;它主要用大模型而非人工规则来筛选代码训练语料,官方称在同等规模的开源模型中表现领先。
深度介绍
官方把 Seed-Coder 的核心主张写成一句话:让代码模型自己为筛选数据。具体做法是主要依靠大模型而不是人工编写的规则来完成代码数据过滤,从而把预训练数据构造中的人力投入降到最低。官方把这一点列为第一条亮点,命名为「以模型为中心」。第二条亮点是透明——公开分享数据流水线的细节,包括 GitHub 数据、提交记录数据与代码相关网页数据各自的处理方法。第三条才是性能:官方称它在同等规模的开源模型中于多种编码任务上表现领先。
整个家族都落在 8B 这一档,但按用途分成三个版本。基础版是在自建的模型中心数据集上预训练的结果,适合继续微调或做补全;指令版经过指令微调以对齐用户意图,可以直接问答;推理版用强化学习提升推理能力,适合算法题与需要多步思考的任务。官方模型表还给出了长度差异:基础版与指令版为 32K,推理版为 64K。三个版本都托管在同一平台的公开集合页里,另有一个半精度格式的推理版。
官方强调公开数据流水线细节,并明确分成三类来源:代码托管平台上的仓库数据、提交记录数据,以及与代码相关的网页数据。它们各自有独立的整理方法,而不是混在一起粗洗。对做训练数据研究的团队,这部分的价值在于可对照——你能看到一套把「模型判断」嵌进数据筛选的具体做法,而不是只看到最终语料。「以模型为中心」也意味着这套流程可以随模型能力升级而自然改进,不必重写规则。
官方仓库给出了两个上手路径:用通用推理库以半精度加载,或走高吞吐推理框架做离线批量推理。指令版在模型卡里写明是因果语言模型、经过预训练与后训练、数据来源为公开数据集与合成数据、上下文长度 32,768。推理版则把长度提到 64K,更适合需要塞进较长题目与尝试过程的场景。对只有单卡的开发者,8B 这一档在量化后基本能落在消费级显卡范围内,社区也已有对应的量化分发。
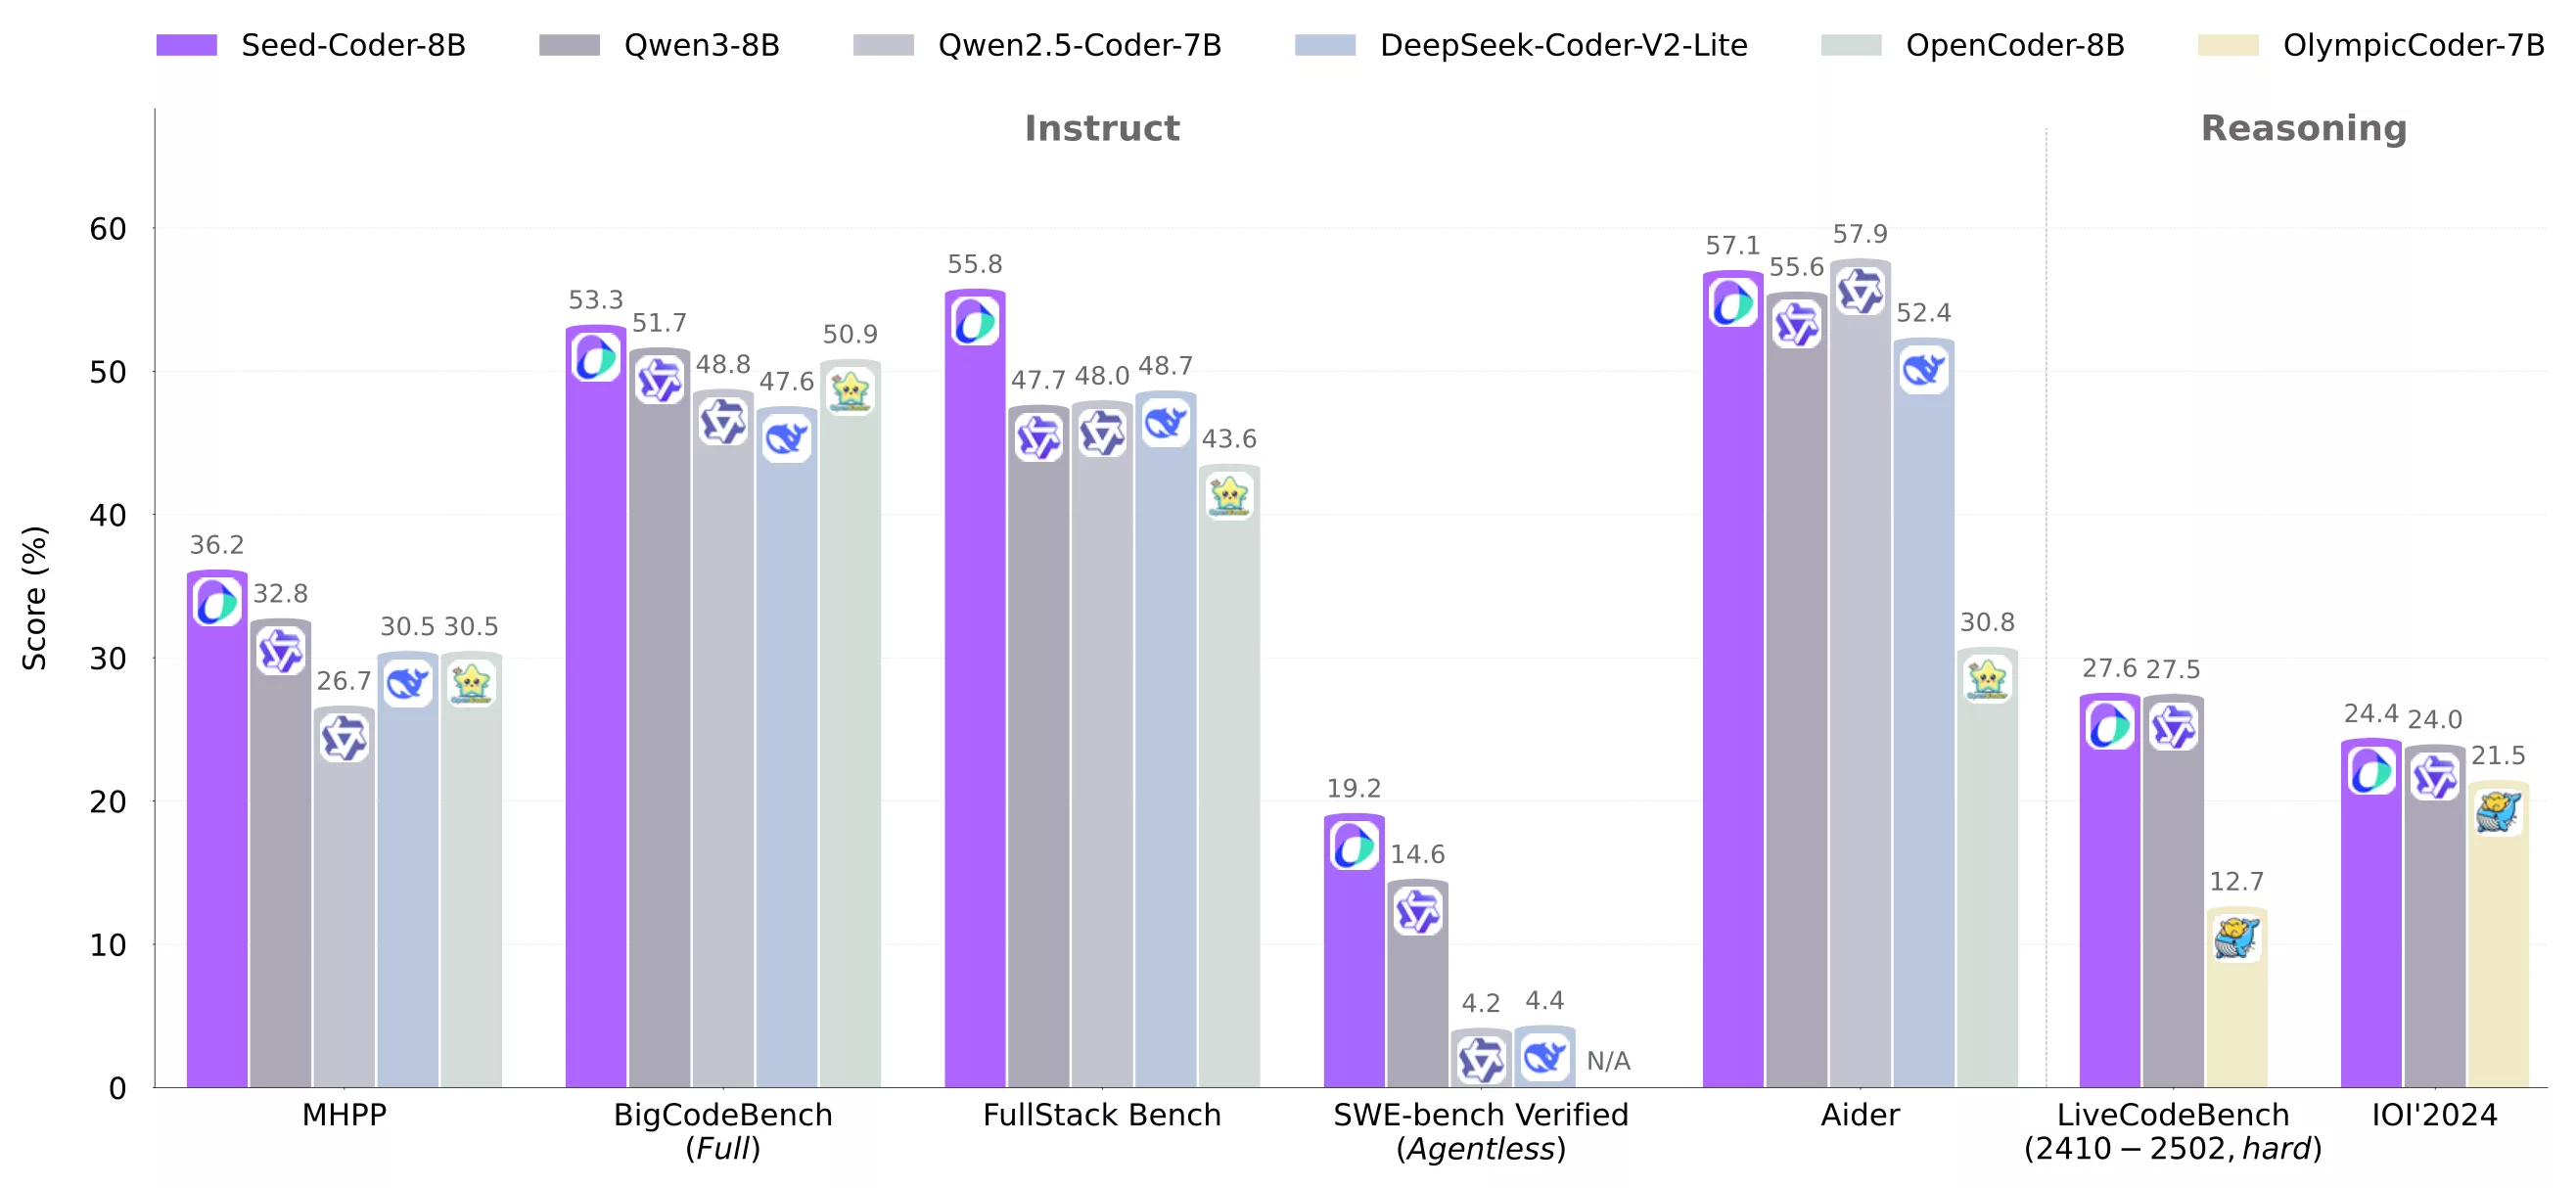
仓库与模型卡里都放了一张性能总览图,用来展示它在多项编码基准上的位置,官方文字结论是「在可比规模的开源模型中达到领先水平」。需要留意的是,官方在发布后主动更正过一次评测设置:公告里说明发现 BigCodeBench 的评测配置不一致,随后把全部相关结果改为对齐后的补全设置重新公布。主动修正评测口径这件事本身,对打算引用其数据的团队是个正面信号。
官方在仓库里说明,Seed-Coder 此前被称为 Doubao-Coder(豆包代码模型),属于同一项目的早期名称。这解释了两个现象:一是部分第三方资料仍在用旧名指代它;二是如果你在模型平台上看到旧命名的条目,很可能指向同一批权重。官方同时把这次开源描述为「为开源大模型生态做贡献的第一步」,措辞上把它的定位放在生态贡献而非商业产品线上。
模型卡上标注的许可是宽松开源许可,代码仓库里也附有对应的许可文件,因此商用与修改都不需要额外授权。这一点和同厂商的通用模型不同,属于真正意义上的开源权重。需要注意的是,模型卡同时写明数据来源包含公开数据集与合成数据;如果下游用途对训练数据来源有严格要求,应当自行核对上游许可与你的合规口径,而不是仅凭模型自身的许可判断。
这条线在 2025 年 5 月发布,此后有过一次评测口径的更正与补充,模型集合保持稳定,没有出现新的代际版本。官方 README 里给出的项目主页链接目前无法访问,因此本页把代码仓库作为主要入口,模型相关的入口全部指向仍在正常服务的权重页与集合页。如果你的需求是找一个体积可控、许可宽松、又能本地跑的代码模型,它仍然是一个可用的选项;如果追求最新能力,则应把它和更新的模型放在一起比较。
产品特点
它把代码语料的过滤工作主要交给大模型完成,人工规则只占很小部分。这种做法随模型能力提升而自然变强,也让整个数据构造流程更容易被复用和审计,官方把这条作为首要卖点。
基础版、指令版与推理版都是 8B,显存需求相近,但分别对应继续微调、直接问答与多步推理三类场景。团队不必为了不同任务准备两套体积差异很大的模型,部署与运维口径可以统一。
发布后官方发现某基准的评测设置不一致,随即把相关结果统一改为对齐后的补全设置并公开说明。相比悄悄改数字,这种处理方式让它的对比数据更值得引用,也提醒使用者核对不同来源的评测口径。
权重以宽松开源许可发布,仓库附有许可文件,商用与修改都无需额外授权。对要在产品里内嵌代码模型的公司,这比需要单独谈授权或限制调用规模的自定义协议省事得多。
最近动态
核验时三个版本的权重页与公开集合页均可正常访问,代码仓库与许可文件也在原位。同时发现官方文档里给出的项目主页链接已返回 404,因此本页把代码仓库作为主要入口,其余按钮全部指向仍在服务的权重页与技术报告。模型本身在此前没有出现新的代际版本。
发布后不久官方在仓库公告里说明,发现其某项代码基准的评测设置存在不一致,已把所有相关结果更新为对齐后的补全设置。这条更正保留在仓库的公告区,属于少数会公开承认并重跑评测的开源项目之一,对使用其公开数据的团队是一个可追溯的凭据。
官方在这一时期发布 Seed-Coder,包含基础版、指令版与推理版三个 8B 模型,并同步公开技术报告与数据流水线的说明。官方给出的三条亮点分别是以模型为中心的数据筛选、透明公开的数据处理方法,以及在同等规模开源模型中的领先表现;同时对外说明该项目此前名为豆包代码模型。
Seed-Coder 是字节跳动 Seed 团队开源的一族代码模型,规模统一在 8B 这一档。官方文档把它与此前的名字一并说明:这个项目早期被称为豆包代码模型,Seed-Coder 是同一路线的正式命名,官方也把这次开源描述为为开源大模型生态做贡献的第一步。 它的核心主张是让代码模型自己为筛选数据:主要是依靠大模型而不是人工编写的规则来完成代码数据过滤,从而把预训练数据构造的人力投入压到最低。官方列出的另外两条亮点分别是透明与性能——前者指公开分享数据流水线细节,包括代码托管平台仓库数据、提交记录数据与代码相关网页数据各自的处理方法;后者指在同等规模的开源模型中于多种编码任务上表现领先。 家族按用途分为三个版本,长度有所不同:基础版是在自建的模型中心数据集上预训练的结果,适合继续微调或做补全,长度 32K;指令版经过指令微调以对齐用户意图,可直接问答,长度 32K;推理版用强化学习提升推理能力,长度提升到 64K,另有半精度格式版本。模型卡写明指令版为因果语言模型、经过预训练与后训练、数据来源包含公开数据集与合成数据。部署上官方给出两条路径:用通用推理库以半精度加载,或走高吞吐推理框架做离线批量推理。 仓库与模型卡都提供了一张性能总览图,官方文字结论是在可比规模的开源模型中达到领先水平。值得记录的是,官方在发布后主动更正过一次评测设置:公告说明发现某项代码基准的配置不一致,随后把全部相关结果改为对齐后的补全设置重新公布。 许可方面,模型卡标注为宽松开源许可,仓库附有对应许可文件,商用与修改都不需要额外授权。需要注意的是数据来源包含公开数据集与合成数据,如果下游用途对训练数据来源有严格要求,应当自行核对上游许可。最后是状态:这条线在 2025 年 5 月发布,此后保持稳定,没有新的代际版本;官方文档里的项目主页链接目前已无法访问,因此主要入口指向代码仓库与仍在服务的权重页。
核验信息
本页事实来自官方渠道:项目代码仓库与 README(家族构成与三个版本、长度差异、以模型为中心与透明与性能三条亮点、数据流水线的三类来源、通用推理库与高吞吐框架两条部署路径、旧名说明、许可文件入口与星标数、公告区的评测口径更正)、各版本模型卡(因果语言模型与训练阶段与数据来源与 32,768 上下文、宽松许可、性能总览图、基础版与推理版入口),以及官方模型集合页与团队站点。页内未列出对照图中出现的第三方模型名称。许可与状态核验于 2026 年 9 月 22 日。
Seed-Coder介绍页面对您是否有帮助?